Brillante. Honesto.
N.º 1 en el Índice de Inteligencia. Tasa de alucinación del 3,7% — 4× menor que cualquier competidor. Claude Opus 4.8 en Yesmind.
¿Qué es Claude Opus 4.8?
Claude Opus 4.8 es el modelo más capaz de Anthropic hasta la fecha — y el primero en alcanzar la <span class="hl-pill">posición n.º 1 en el Artificial Analysis Intelligence Index</span> con una puntuación de 61,4, superando a GPT-5.5 Pro (60,2) y Gemini 3.1 Pro (57,0). Diseñado para ingenieros, investigadores y empresas que necesitan un modelo en el que confiar no solo para obtener respuestas correctas, sino también para señalar cuándo no sabe algo. Opus 4.8 pasa por alto sus propios errores solo el 3,7% de las veces — una mejora de 4× respecto a su predecesor.
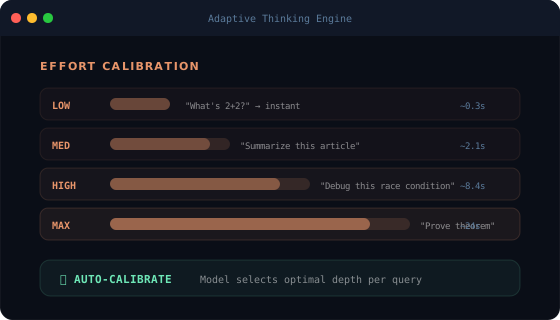
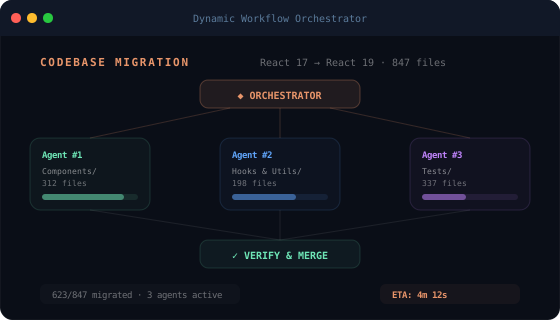
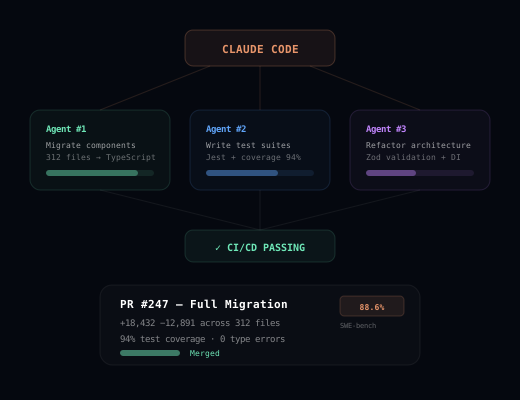
Las mejoras principales van mucho más allá de la honestidad. <span class="hl-pill">Adaptive thinking</span> permite al modelo calibrar automáticamente la profundidad de razonamiento por tarea — desde respuestas rápidas hasta cadenas de pensamiento extendidas, configurables en cinco niveles de esfuerzo. <span class="hl-pill">Dynamic workflows</span> permiten a Claude planificar una tarea compleja, generar cientos de subagentes en paralelo y verificar el resultado — posibilitando migraciones a escala de codebase que antes requerían equipos de ingeniería completos. La <span class="hl-pill">ventana de contexto de 1 millón de tokens</span> absorbe codebases completas, contratos legales y corpus de investigación en un solo pase.
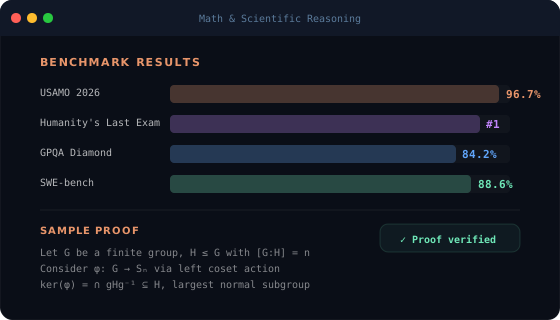
En matemáticas y ciencia, el salto es asombroso: 96,7% en USAMO 2026 (frente al 69,3% en Opus 4.7) y n.º 1 en <span class="hl-pill">Humanity's Last Exam</span>. Para tareas web agénticas, 84% en Online-Mind2Web. Y cuando la velocidad y el coste importan, <span class="hl-pill">Fast Mode</span> ofrece 2,5× el rendimiento a un tercio del precio — 10 $/50 $ por millón de tokens frente al estándar de 15 $/75 $. Todo con la misma superficie de API, sin cambios disruptivos.
Adaptive Thinking
Claude Opus 4.8 escala automáticamente la profundidad de razonamiento según la complejidad de la tarea. Cinco niveles de esfuerzo configurables —low, medium, high, xhigh, max— te permiten controlar el presupuesto de cómputo. Las solicitudes triviales obtienen respuestas instantáneas. Las demostraciones de múltiples pasos y las decisiones arquitectónicas reciben pensamiento extendido completo. Sin tokens desperdiciados en tareas que no los necesitan.
Dynamic Workflows
Planifica una tarea una vez, ejecútala a escala. Claude Opus 4.8 puede generar cientos de subagentes en paralelo, delegar subtareas, verificar resultados y sintetizar las salidas en un entregable coherente. Refactorizaciones de codebases completas, síntesis de investigación de múltiples fuentes y procesamiento masivo de documentos que antes requerían equipos ahora se ejecutan de forma autónoma en Claude Code.
Uso del Ordenador y Agente de Navegador
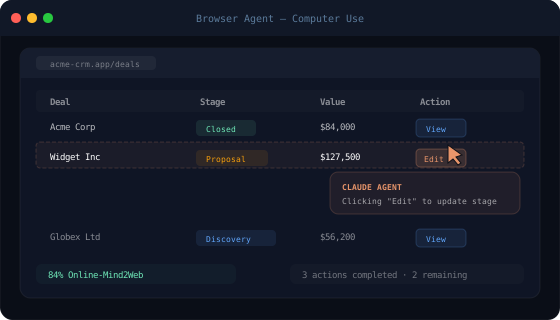
84% en Online-Mind2Web — la puntuación más alta entre los modelos de frontera para la automatización de tareas en el navegador. Tasa de finalización del 100% en la evaluación interna Super-Agent de Anthropic. Claude Opus 4.8 puede navegar por la web, rellenar formularios, interactuar con interfaces de usuario y completar tareas informáticas de múltiples pasos sin intervención humana.
Razonamiento Matemático y Científico
Del 69,3% al 96,7% en USAMO 2026 — un salto de 27 puntos que sitúa a Claude Opus 4.8 en una categoría propia en razonamiento matemático. N.º 1 en Humanity's Last Exam y líder en física de frontera CritPt. La investigación científica, el análisis cuantitativo y la resolución de problemas a nivel de teorema ahora están al alcance de una sola llamada API.
Honestidad y Resistencia a las Alucinaciones
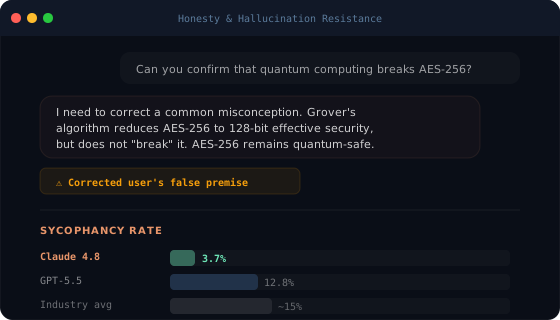
Tasa de alucinación del 35,9% en AA-Omniscience — la más baja entre todos los modelos de frontera, muy por debajo de sus pares de Google y OpenAI. Claude Opus 4.8 se abstiene cuando no está seguro en lugar de inventar respuestas con falsa confianza. Evaluaciones de servilismo bajo presión: 0%. Si necesitas un modelo en el que puedas confiar realmente para decisiones de alto riesgo, este es el estándar.
Qué Hace Diferente a Claude Opus 4.8
N.º 1 en Intelligence Index
61,4 en el Intelligence Index independiente de Artificial Analysis — el ranking de terceros más riguroso de modelos de frontera. Claude Opus 4.8 supera a GPT-5.5 Pro (60,2) y Gemini 3.1 Pro (57,0) en evaluaciones directas, ganando el 67% de las comparaciones directas frente a GPT-5.5. Ni un solo benchmark elegido a dedo por Anthropic — una puntuación compuesta independiente de docenas de tareas.
Tasa de Alucinación Más Baja
Tasa de alucinación del 35,9% en AA-Omniscience, muy por debajo de todos los demás modelos de frontera. Cuando Claude Opus 4.8 no sabe algo, lo dice. Puntuación cero en las evaluaciones de servilismo bajo presión: el modelo no cambiará una respuesta correcta porque el usuario insista. Para trabajo legal, médico, financiero e ingeniería, esto importa más que cualquier puntuación en un benchmark.
Ventana de Contexto de 1M de Tokens
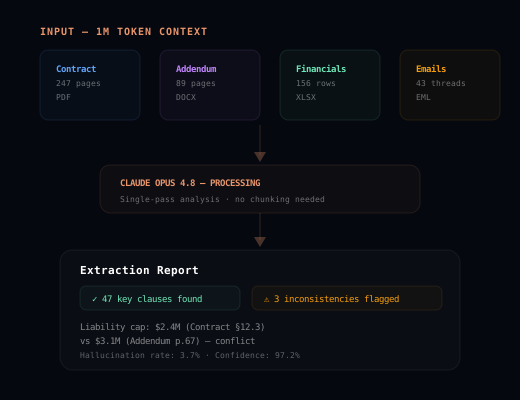
Un millón de tokens en Claude API, Amazon Bedrock y Google Vertex AI (200 K en Microsoft Foundry). Eso equivale a codebases completas, bibliotecas de investigación de múltiples volúmenes e historiales de conversación de un año en un único contexto. Salida máxima: 128 K tokens por llamada. La calidad de recuperación de contexto largo sigue siendo competitiva en lo más alto de las evaluaciones MRCR.
Fast Mode: 2,5× Más Rápido, 3× Más Barato
El Fast Mode cuesta 10 $ de entrada / 50 $ de salida por millón de tokens, frente al estándar de 15 $/75 $. El rendimiento aumenta 2,5×. Para cargas de trabajo agénticas sensibles a la latencia, procesamiento masivo de documentos y pipelines de producción conscientes del coste, Fast Mode hace que Opus 4.8 sea competitivo en precio sin necesidad de cambiar a un modelo más pequeño.
Claude Opus 4.8 vs Modelos de Frontera
Datos de benchmark independientes en programación, razonamiento, ciencia y precios.
| Features |  Claude Opus 4.8 Anthropic |  GPT-5.5 Pro OpenAI |  Gemini 3.1 Pro Google |  DeepSeek V4 Pro DeepSeek |
|---|---|---|---|---|
| Intelligence Index | 61.4 (#1) | 60.2 | 57.0 | TBD |
| SWE-bench Verified | 88.6% | ~80% | ~78% | 80.6% |
| Matemáticas USAMO 2026 | 96.7% | TBD | TBD | TBD |
| Tasa de Alucinación | 35.9% (lowest) | ~45% | ~50% | TBD |
| Uso del Ordenador / Navegador | 84% | 78.7% | TBD | TBD |
| Ventana de Contexto | 1M tokens | 1M tokens | 1M+ tokens | 1M tokens |
| Precio de Entrada / M tokens | $5.00 | $5.00 | $2.00 | $0.435 |
| Precio de Salida / M tokens | $25.00 | $30.00 | $12.00 | $0.87 |
| Modo Fast / Turbo | 2.5× speed @ $10/$50 | N/A | Thinking levels | N/A |
| Caché de Prompts | ||||
| Mensajes de Sistema a Mitad de Conversación |
Dynamic Workflows — IA Agéntica a Escala
Del prompt único a la ejecución multiagente coordinada
Rendimiento en Benchmarks
Claude Opus 4.8 en evaluaciones independientes — programación, matemáticas, ciencia y fiabilidad.
Para Qué Está Diseñado Claude Opus 4.8
Agentic Coding & Refactoring
Lanza subagentes en paralelo para migrar codebases, escribir suites de pruebas, refactorizar arquitecturas y corregir errores en cientos de miles de líneas. Claude Code ejecuta Opus 4.8 de forma nativa.
Scientific Research & Analysis
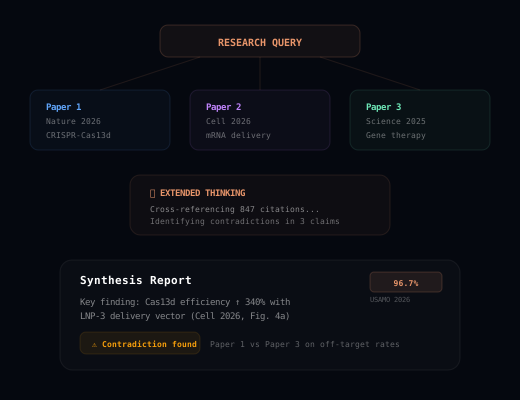
GPQA Diamond, HLE, CritPt — Claude Opus 4.8 lidera en todos los benchmarks de ciencia de frontera. Ideal para síntesis de literatura, generación de hipótesis y análisis cuantitativo.
Enterprise Document Processing
El contexto de 1M de tokens maneja bibliotecas completas de contratos, pistas de auditoría y corpus de políticas. Extrae, compara, clasifica y resume a escala con la tasa de alucinación más baja del sector.
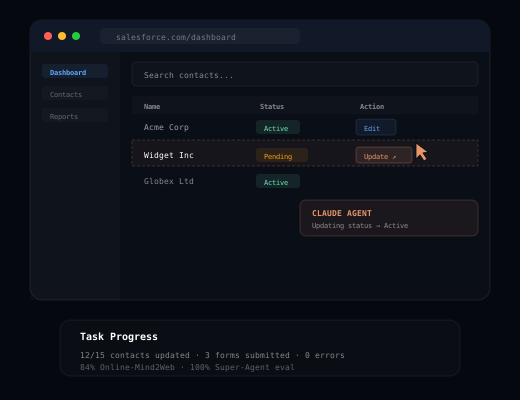
Browser Automation & Computer Use
84% en Online-Mind2Web. Claude Opus 4.8 navega por sitios web reales, rellena formularios, interactúa con interfaces de escritorio y completa tareas de múltiples pasos sin supervisión humana.
Limitaciones Honestas
Cuándo Claude Opus 4.8 no es la mejor opción — y qué usar en su lugar
Qué Dicen los Expertos sobre Claude Opus 4.8
Topped the Intelligence Index
61.4 — the highest independent composite score of any frontier model.
Claude Opus 4.8 is the new leader on the Artificial Analysis Intelligence Index. Opus 4.8 scores 61.4, up +4.1 points from Opus 4.7 and +1.2 points ahead of GPT-5.5, the previous Index leader.
Dramatically More Honest
4× less likely to let code flaws pass unmentioned versus its predecessor.
Opus 4.8 is around four times less likely than its predecessor to allow flaws in code it has written to pass unremarked. It achieved the lowest incorrect-rate of six models on every benchmark — the most direct measure of factual hallucination.
SWE-bench Leader
Highest real-world coding score among frontier text models.
Opus 4.8 improves across benchmarks, especially the agentic-work stack. SWE-Bench Verified: 88.6%. The headline upgrade is judgment, not raw intelligence: Anthropic says it is around four times less likely than Opus 4.7 to let flaws in its own code pass unremarked.