Gemini Omni - creación y edición de Vídeo con IA multimodal
El modelo de vídeo IA multimodal de Google combina texto, imágenes, audio y vídeo, lo que permite editar todo a través de una conversación. La evolución de omni flash ai hacia toda la familia Omni marca una nueva etapa en la creación cinematográfica con IA de Google DeepMind.
¿Qué es Gemini Omni?
Gemini Omni es el modelo de generación multimodal que Google DeepMind anunció en Google I/O 2026 el 19 de mayo. Como google deepmind modelo de vídeo de nueva generación, está construido sobre una arquitectura transformer nativa multimodal que fusiona la inteligencia de razonamiento de Gemini con capacidades avanzadas de renderizado de medios. Acepta cualquier combinación de texto, imágenes, audio y vídeo como entrada, y genera vídeo de alta calidad con audio sincronizado, acercándose a la visión de Google de «crear cualquier cosa a partir de cualquier entrada». El contenido multimodal ia que produce responde tanto a palabras como a referencias visuales, sonoras y de movimiento al mismo tiempo, no en secuencia, sino en paralelo.
El primer modelo de la familia es el omni flash modelo, una variante optimizada para velocidad ya disponible en Gemini App, Google Flow y YouTube Shorts. Omni Flash genera clips de aproximadamente 10 segundos con resolución de hasta 4K y audio incluido. Google lo concibe como modelo del mundo ia: no solo renderiza píxeles, sino que razona sobre física, cultura, historia y ciencia para que cada escena sea coherente con la realidad. Los futuros modelos de la familia Omni ampliarán la generación de imágenes, la salida de audio independiente y los formatos de vídeo más largos. Omni reemplaza oficialmente a Veo como el modelo de vídeo principal de Google.
Omni continúa la evolución iniciada por google veo video ai en la generación de vídeo de Google. Frente al enfoque centrado en la generación de contenido, incorpora nuevas capacidades como el uso combinado de texto, imágenes, audio y vídeo, además de la edición mediante instrucciones en lenguaje natural. Puedes probar Gemini Omni directamente en nuestra plataforma, donde podrás generar y editar vídeos con IA desde el navegador, combinando tus propias fotos, clips y descripciones para crear algo completamente nuevo, sin instalar nada ni cambiar de cuenta.
Qué hace diferente a Gemini Omni
Editar vídeos mediante conversación
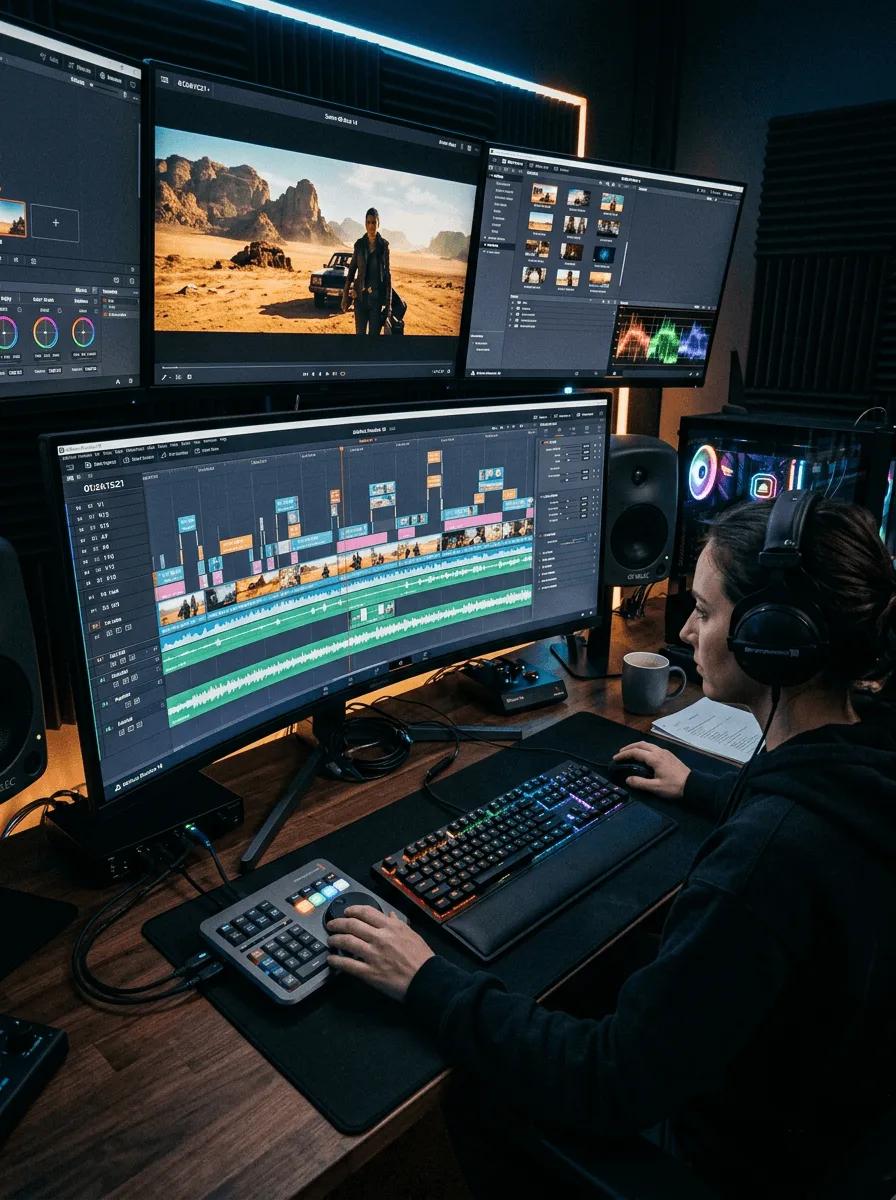
La mayoría de las herramientas de vídeo IA funcionan en una sola dirección: prompt dentro, clip fuera. Si quieres cambios, puedes reescribir el prompt desde cero y regenerar. La edición conversacional de vídeo de Gemini Omni cambia esa dinámica. Cada instrucción se construye sobre la anterior: si cambias el fondo, el personaje permanece; si pides luz más cálida, la composición se mantiene. Esto es la edición multi-turn en la práctica: un diálogo turno a turno donde el modelo mantiene una representación interna de la escena a través de cada ronda de refinamiento.
Sin línea de tiempo, sin capas ni keyframing. Solo describes lo que debe cambiar y el modelo aplica la modificación conservando la consistencia de escena.
Combinar entradas y generar una salida
El texto es solo el punto de partida. Omni acepta imágenes, clips de audio, vídeos existentes y texto en cualquier combinación y razona sobre todos ellos simultáneamente. No funciona como un pipeline que convierte primero todo a texto, sino como un sistema de IA multimodal nativo. La interpretación de los prompts de vídeo es más precisa porque el modelo trabaja directamente con medios reales y no solo con descripciones de esos medios.
Entender el mundo para generar vídeo
Omni ai no renderiza píxeles a ciegas. Su enfoque de modelo del mundo ia le permite entender gravedad, dinámica de fluidos, contexto cultural y lógica narrativa. Por ejemplo, una animación en plastilina sobre el plegamiento de proteínas puede generarse con explicaciones narradas y un alto nivel de precisión científica. En lugar de limitarse a imitar imágenes, el enfoque cinematográfico IA de Omni busca comprender el mundo que representa.
Mantener la coherencia entre ediciones
Los personajes se mantienen estables entre ediciones y la iluminación persiste de forma coherente, ya que cada modificación se construye sobre una representación interna de la escena en lugar de regenerarse desde cero. Esa continuidad es lo que diferencia a un verdadero editor conversacional de un simple generador de clips tradicional.
Características principales
Entrada combinada de varios formatos
Combina texto, imágenes, audio y vídeo en un solo prompt. Omni razona sobre todas las entradas simultáneamente y la entrada de referencia dirige el proceso creativo.
Hasta resolución 4K
La resolución 4k vídeo ia garantiza salidas de alta definición aptas para contenido profesional, marketing y redes sociales.
Vídeo con audio sincronizado
El vídeo ia con audio incluye narración vocal, ambiente sonoro y diálogo sincronizado generado junto al vídeo en el mismo proceso, no añadido después.
Edición conversacional
Refinar vídeo turno a torno, cambiar estilos, intercambiar elementos y ajustar cámara sin perder coherencia de escena. Cada instrucción añade al resultado anterior.
Transferencia de estilo y sustitución de elementos
La transferencia de estilo de vídeo aplica la estética de imágenes de referencia. La sustitución de elementos de vídeo intercambia objetos, personajes o entornos mediante texto.
Cómo funciona
Guía Paso a Paso
Elegir entradas
Texto a vídeo, o crear video desde foto, audio o un clip existente, en cualquier combinación. También puedes arrastrar referencias para definir y mantener el estilo, el movimiento o el estado de ánimo.
Obtener resultado generado por Omni
El modelo razona sobre todas las entradas y construye un vídeo coherente con audio. Crear y editar vídeos con ia con el conocimiento del mundo de Gemini: física, cultura, ciencia, lógica narrativa.
Edición mediante conversación
Con ajustes en lenguaje natural como “cambia el fondo” o “añade lluvia”, mientras la edición multi-turn mantiene el estado de la escena de forma coherente a lo largo de toda la sesión.
De Veo a Omni: el camino de la generación de vídeo de Google
| Features |  Veo 2 | Veo 3 | Veo 3 | Omni Flash |
|---|---|---|---|---|
| Lanzamiento | Dec 2024 | May 2025 | Oct 2025 | May 2026 |
| Resolución Máxima | 4K | 4K | 4K | 4K |
| Audio | None | Native dialogue | Enhanced dialogue | Synchronized multimodal |
| Tipos de Entrada | Text, image | Text, image | Text, image | Text, image, audio, video |
| Edición | None | None | None | Conversational multi-turn |
| Duración | ~8s | ~8s | ~15s | ~10s (expanding) |
| Física | Basic | Improved | Good | World model grounding |
| Integración | AI Studio | Gemini, Flow | Gemini, Flow, Vids | Gemini, Flow, YouTube |
- Veo estableció la posición de Google en vídeo IA con generación de diálogo nativo líder en el sector. Veo 3 fue el primer modelo en generar habla realista sincronizada con movimiento labial. La comparación modelos de vídeo ia entre cada versión de Veo muestra una progresión clara hacia mayor realismo, duración y capacidad de integración con el ecosistema de Google.
- Para Omni, en lugar de actualizar la pipeline de generación de Veo, Google reconstruyó desde cero alrededor de la entrada multimodal y la edición conversacional. El omni flash modelo intercambia duración de clip (10s frente a los 15s de Veo 3.1) por una flexibilidad editorial que ningún otro modelo ofrece actualmente en el mercado.
- El límite inicial de 10 segundos es una decisión de lanzamiento: Google priorizó un acceso más amplio en lugar de permitir duraciones más largas desde el principio. Las extensiones de duración están previstas para futuras actualizaciones. Para creadores que ya usaban Veo, Omni es el nuevo entorno donde se concentra la generación de vídeo dentro del ecosistema de Google.
Antes / Después
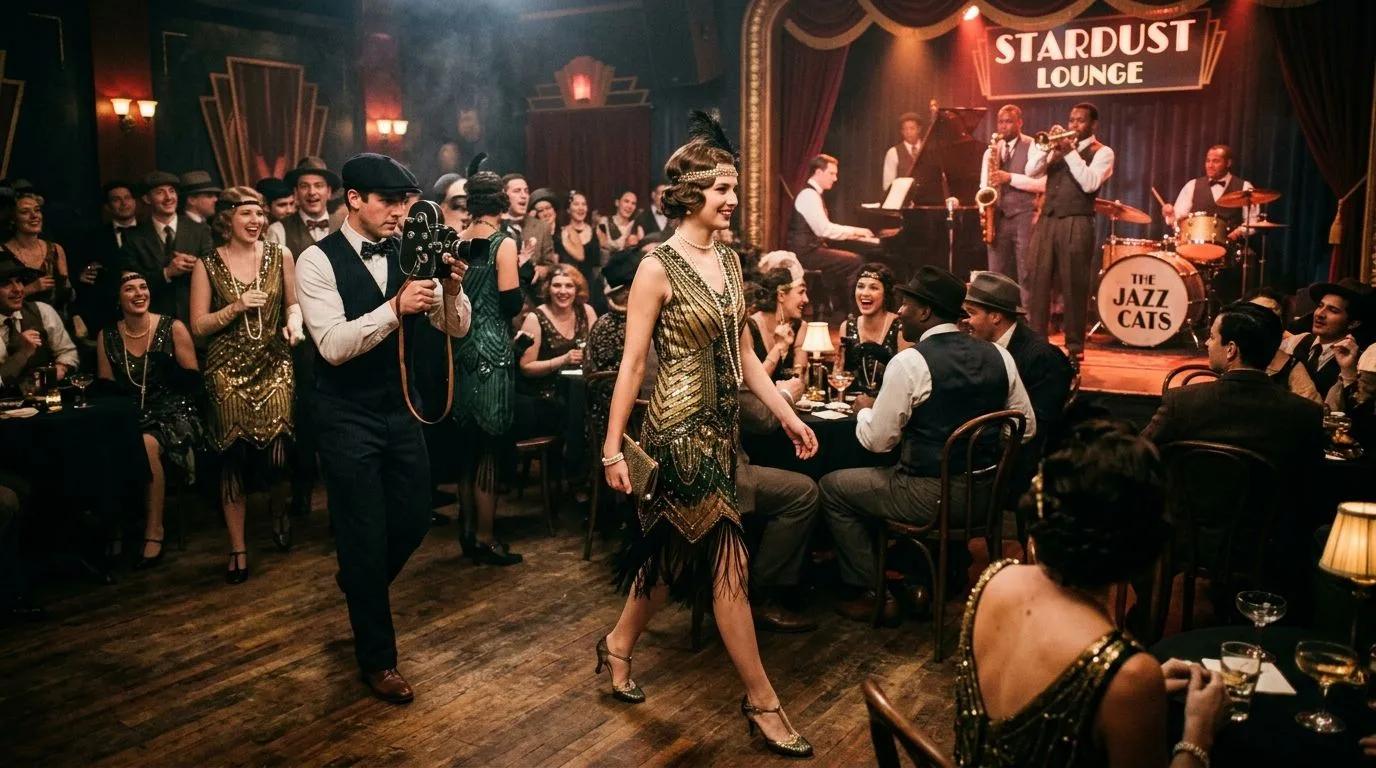
De Foto Fija a Historia Animada
Un ejemplo directo de crear vídeo a partir de una foto como punto de partida creativo.
De clip simple a transferencia de estilo
La transferencia de estilo conserva el movimiento y el ritmo del vídeo original.
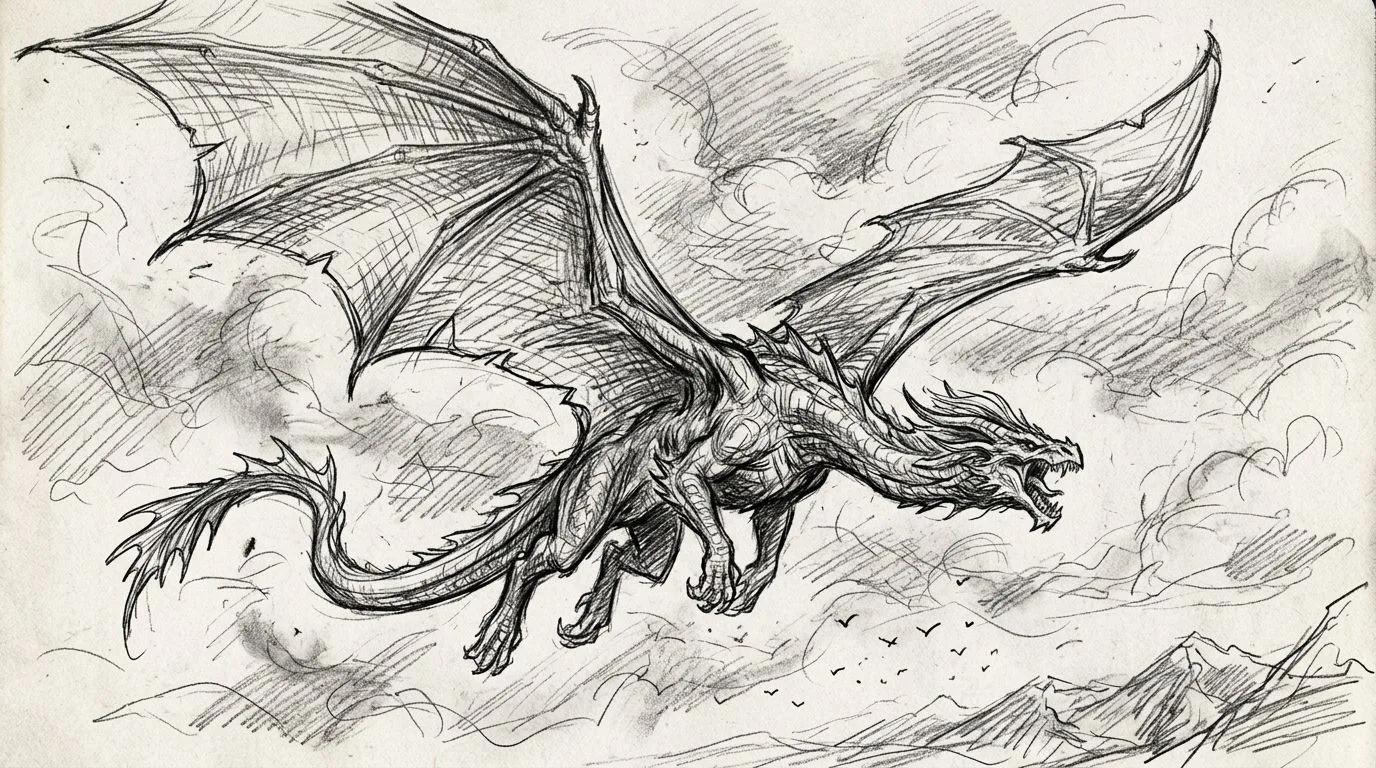
De boceto a material realista
La transformación es completa.
Cómo los creadores usan Gemini Omni
Por qué los creadores eligen Gemini Omni
Modelo de vídeo verdaderamente multimodal
Omni razona sobre texto, imágenes, audio y vídeo simultáneamente creando una salida que refleja todas las entradas a la vez.
"Este nuevo modelo es mucho más realista, entiende mucho mejor el lenguaje natural y es capaz de nutrirse de todo el conocimiento y el razonamiento de Gemini. Ya no hace solo lo que le pides, sino que utiliza otros modelos de la IA de Google para que cada parte del vídeo sea lo más realista possible."
Editar vídeos como si fuera un documento
La edición conversacional elimina la línea de tiempo. Puedes describir lo que necesitas cambiar, y el modelo lo aplica manteniendo todo lo demás intacto.
"Hablamos de edición de video profesional con lenguaje natural, sin necesidad de tocar un software de edición tradicional"
No se trata solo de una actualización de Veo
Omni no es Veo 4. Es una nueva arquitectura que fusiona el razonamiento de Gemini con el renderizado de medios en un único sistema.
"La propia Google DeepMind pide pensar en Gemini Omni como en Nano Banana, pero para vídeo. La referencia tiene sentido porque Nano Banana fue el generador de imágenes de Google que llevó la creación visual con IA a una escala muy llamativa"
El conocimiento del mundo importa
Omni entiende el mundo que renderiza. Pide una escena histórica y conoce la arquitectura de la época. Pide una explicación científica y los datos cuadran con la realidad.
"Si le pides, por ejemplo, que cree un vídeo en el que se ve a una persona nadando en el océano Índico, buscará las características de esas aguas para tener en cuenta cómo debe crear cada detalle"
El ecosistema creativo de Google
Omni vive dentro de Gemini, Google Flow, YouTube Shorts y YouTube Create. Para creadores en el ecosistema de Google, la adopción es natural.
"Omni es el sucesor de Nano Banana, Genie y Veo, y se basa en los avances obtenidos con esos modelos, pero con importantes mejoras en la comprensión de cómo funcionan las físicas y las órdenes del usuario"
Un paso más allá del reconocimiento de patrones
Omni marca la transición desde la generación tradicional de prompt a salida hacia un modelo de creación más interactivo y flexible.
"En medio de una cascada de anuncios, hubo uno que se robó toda la atención desde el primer momento que apareció en el escenario: Gemini Omni, el nuevo modelo que promete redefinir por completo cómo los usuarios interactúan con la IA de Google"
Comparar modelos de vídeo IA en nuestro sitio
Comparación de Gemini Omni con otros modelos disponibles en nuestra plataforma.
| Features | Omni Flash |  Sora 2 |  Runway Gen-4 |  Kling 3.0 |  Wan 2.1 |
|---|---|---|---|---|---|
| Arquitectura | Multimodal Transformer | DiT | Temporal Transformer | DiT 3D VAE | DiT (Open Source) |
| Tipos de Entrada | Text+Image+Audio+Video | Text+Image | Text+Image | Text+Image | Text+Image |
| Resolución Máxima | 4K | 1080p | 4K | 1080p+ | 720p |
| Audio Nativo | Yes (sync) | ||||
| Edición Conversacional | Yes (multi-turn) | ||||
| Avatares Digitales | Cameos (discontinued) | ||||
| Duración | ~10s | ~20s | ~10s | ~10s | 5s |
| Física | World model | Good | Good | Excellent | Good |
| Ideal Para | Multimodal creation + editing | Cinematic generation | Professional VFX | Human realism | Self-hosted, custom |
- Si la prioridad es editar y refinar vídeos mediante instrucciones en lenguaje natural, Omni se diferencia por combinar texto, imagen, vídeo y audio en un mismo flujo de trabajo. Sora destaca por la duración de sus clips, mientras que Runway Gen-4 ofrece un control más preciso para efectos visuales, pero ninguno de los dos integra de la misma manera la edición conversacional multimodal.