685B cerebro. 52B activos.

DeepSeek V4 Pro — Mixture-of-Experts enruta cada consulta a subredes especializadas. Conocimiento de frontera a coste de modelo mediano. En Yesmind.

Mixture-of-Experts — Enrutamiento Activo
Code
Gen
Math
Logic
Bio
Med
Legal
Doc
NLP
Core
Vision
Parse
Chem
Mol
Reason
Chain
Trans
late
Data
Struct
Consulta: "Optimiza esta consulta SQL" → 4 de 10 grupos de expertos activos · 52B parámetros usados
685B
Parámetros Totales
52B
Activos por Consulta
92%
Ahorro en Cómputo
80.6%
SWE-bench Verificado
$0.435
Por 1M tokens entrada
MIT
Licencia Open Source
1M
Ventana de Contexto

¿Qué es DeepSeek V4 Pro?

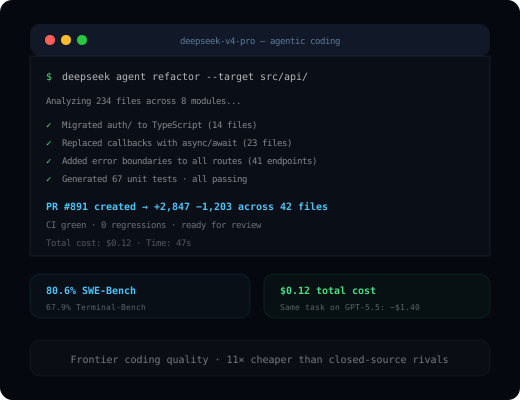
DeepSeek V4 Pro es un <span class="hl-pill">modelo de lenguaje grande de clase frontera</span> que rompe con la creencia de que la IA de vanguardia tiene que ser cara y cerrada. Publicado en 2026 bajo una <span class="hl-pill">licencia MIT</span>, alcanza el 80,6% en SWE-bench Verified — igualando a Claude Opus 4.8 y acercándose a GPT-5.5 — con un coste de tan solo $0,435 por millón de tokens de entrada. Eso es aproximadamente 30 veces más barato que Claude y 11 veces más barato que GPT-5.5 con una calidad de salida equivalente.

El modelo se basa en una <span class="hl-pill">arquitectura Mixture of Experts (MoE)</span> con 1,6 billones de parámetros totales pero solo 49.000 millones activos por token. Este diseño otorga a DeepSeek V4 Pro la amplitud de conocimiento de un modelo masivo manteniendo los costes de inferencia cercanos a los de un modelo denso de tamaño medio. El resultado: inteligencia de frontera sin precios de frontera.

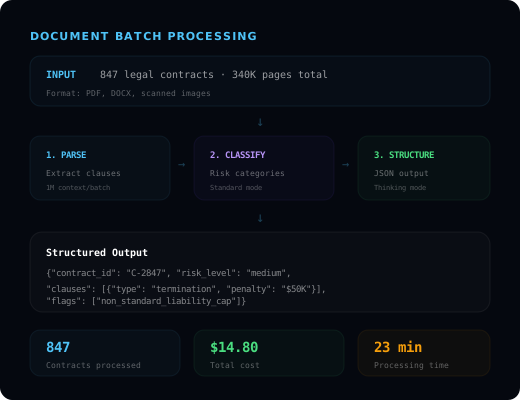
DeepSeek V4 Pro admite una <span class="hl-pill">ventana de contexto de 1 millón de tokens</span>, tres modos de razonamiento adaptativos, una API totalmente compatible con OpenAI y flujos de trabajo de llamadas a funciones agénticas. Fue entrenado en hardware Huawei Ascend AI — el primer modelo de frontera construido completamente fuera del ecosistema Nvidia — demostrando que la independencia de la cadena de suministro y la excelencia investigadora pueden coexistir.

En Yesmind, accedes a DeepSeek V4 Pro directamente a través de nuestra interfaz unificada — sin claves API separadas, sin migración de SDK, sin configuración adicional. Una suscripción, todos los modelos de frontera.

80.6 %
SWE-bench Verified
$0.43 /M
Tokens de Entrada
1.6 T
Parámetros Totales
1 M
Contexto de Tokens
1

Eficiencia de Costes Extrema

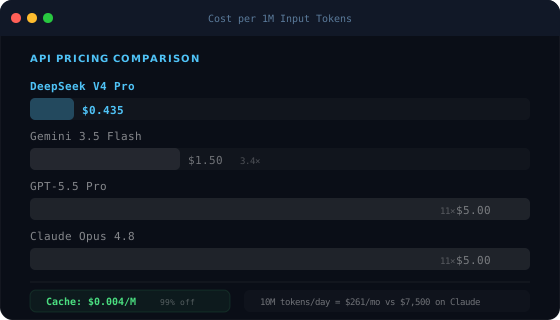
$0,435/M de entrada — 11× más barato que GPT-5.5, 29× más barato que Claude Opus. Caché de hits a $0,004/M. Una carga de 10 millones de tokens/día: $261/mes frente a $7.500 con Claude.

2

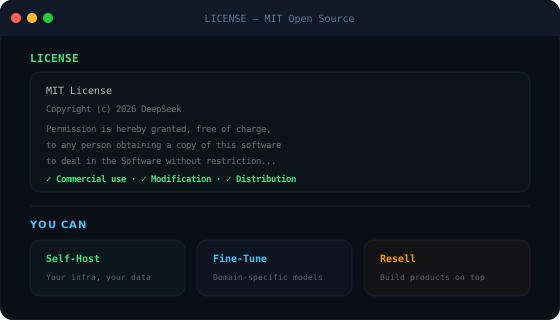
Licencia MIT — Código Abierto de Verdad

Alójalo tú mismo, ajústalo, revéndelo — sin restricciones. A diferencia de la licencia de Llama: sin límites de usuarios, sin requisitos de nomenclatura, sin excepciones. Pesos disponibles en HuggingFace.

3

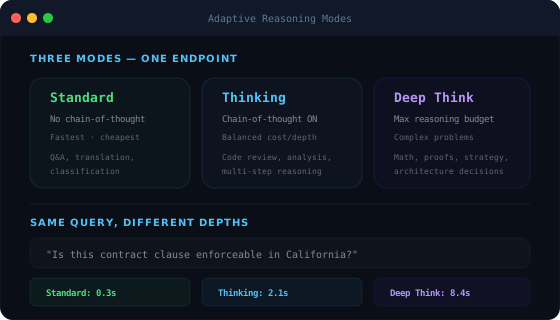
Tres Modos de Razonamiento Adaptativos

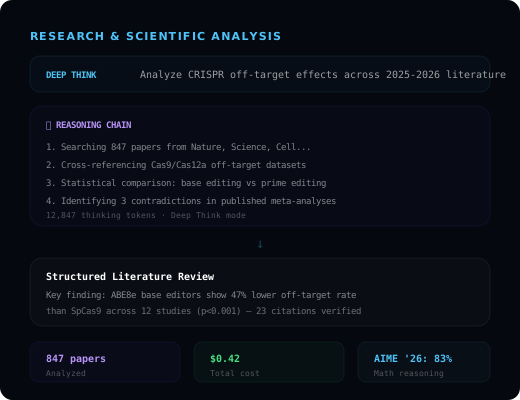
Estándar: rápido, sin cadena de pensamiento. Thinking: razonamiento equilibrado para código y análisis. Deep Think: máxima profundidad para demostraciones y arquitectura. Un endpoint, tres perfiles.

4

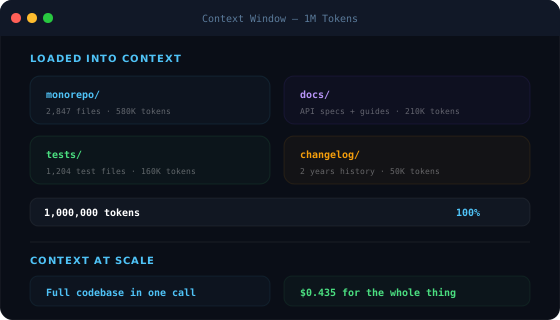
Ventana de Contexto de 1 Millón de Tokens

Bases de código completas, contratos legales, bibliotecas de investigación — en una sola pasada. La atención híbrida reduce los FLOPs al 27% de V3.2 con contexto de 1M. Contexto largo económicamente viable.

5

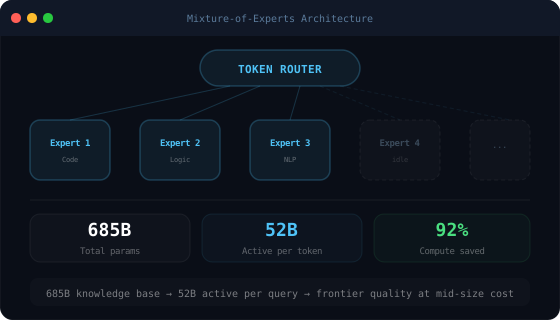
Arquitectura MoE — Conocimiento Masivo, Coste Moderado

685.000 millones de parámetros totales, 52.000 millones activos por token. El enrutador selecciona grupos de expertos especializados por consulta — conocimiento de frontera al coste computacional de un modelo mediano. 92% de ahorro frente al equivalente denso.

6

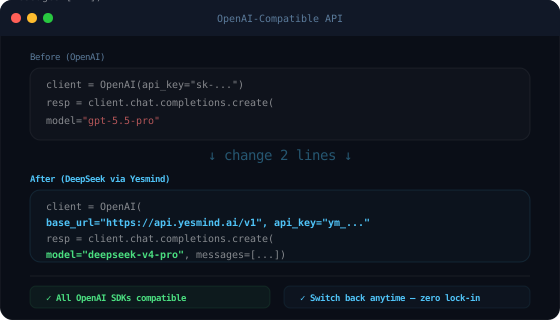
API Compatible con OpenAI — Sin Migración

Cambia base_url y el nombre del modelo — eso es todo. Todos los SDK de OpenAI funcionan. También admite el formato Anthropic. Sin dependencias del proveedor, vuelve cuando quieras.
Eficiencia de costes de DeepSeek V4 ProCódigo abierto con licencia MITTres modos de razonamientoContexto de 1 millón de tokensArquitectura Mixture of ExpertsAPI compatible con OpenAI

DeepSeek V4 Pro vs. los Mejores Modelos de IA

Cómo compara DeepSeek V4 Pro con GPT-5.5, Claude Opus 4.8 y Llama 4 Maverick en benchmarks, precios y acceso de código abierto.

Features
DeepSeek V4 Pro
DeepSeek AI
GPT-5.5
OpenAI
Claude Opus 4.8
Anthropic
Llama 4 Maverick
Meta
SWE-bench Verified 80.6%~80%80.6%~65%
LiveCodeBench 93.5%~90%~88%TBD
Puntuación en Codeforces 3,206TBDTBDTBD
Ventana de Contexto 1M tokens1M tokens200K+1M tokens
Precio de Entrada $0.435/M$5/M$15/MFree (open)
Precio de Salida $0.87/M$30/M$25/MFree (open)
Código Abierto
Autoalojable
Modos de Razonamiento 3 (Non-Think / High / Max)Standard + ThinkingStandard + ExtendedStandard
Hardware de Entrenamiento Huawei AscendNvidiaNvidiaNvidia

Cómo Funciona DeepSeek V4 Pro

Enrutamiento MoE — conocimiento de frontera al coste de inferencia de un modelo mediano
Tu Prompt Entra en el Modelo

Cada solicitud se tokeniza y se envía a la capa de enrutamiento de DeepSeek V4 Pro. La red de compuertas MoE evalúa al instante qué subredes expertas son más relevantes para tu entrada concreta — código, matemáticas, lenguaje o razonamiento — antes de que comience cualquier operación computacionalmente costosa.

49.000 Millones de Parámetros Activos Gestionan la Inferencia

De los 1,6 billones de parámetros totales, solo ~49.000 millones se activan por token. Los expertos seleccionados procesan tu solicitud con la profundidad de un modelo masivo, pero al coste computacional de un modelo denso de tamaño medio. Por eso DeepSeek V4 Pro ofrece calidad de salida de frontera a $0,435/M en lugar de $5–$15/M.

Salida Entregada con Razonamiento Profundo Opcional

La respuesta se ensambla a partir de las salidas de los expertos y se devuelve mediante el modo de razonamiento elegido. Non-Think para respuestas instantáneas. Think High para cadenas de razonamiento paso a paso. Think Max para la resolución de problemas con máxima profundidad. Un modelo, tres puntos de operación coste-calidad — tú controlas el equilibrio por solicitud.

La Ventaja del Código Abierto

Por qué la licencia MIT lo cambia todo en el despliegue de IA

01
Licencia MIT — Sin Restricciones Comerciales
La licencia MIT es la licencia de código abierto más permisiva. Usa DeepSeek V4 Pro en productos comerciales, aplicaciones SaaS y software empresarial sin ninguna obligación de royalties. Sin límites de usuarios. Sin requisitos de nomenclatura para derivados. Sin restricciones de ámbito de uso. A diferencia de la licencia de Llama de Meta, no hay excepciones que excluyan grandes despliegues. Construye productos, véndelos y quédate con todos los ingresos.
02
Alójalo en Tu Propia Infraestructura
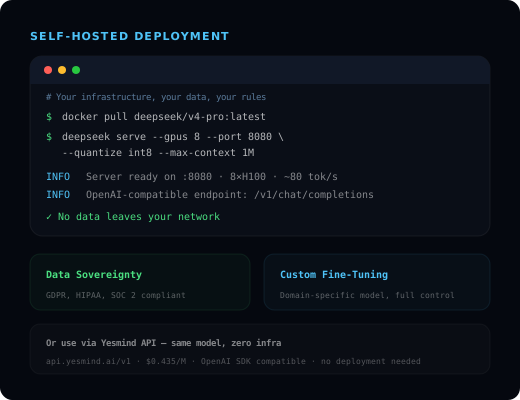
Descarga los pesos del modelo desde HuggingFace y ejecuta DeepSeek V4 Pro completamente en tu propio hardware — en la nube, en local o en entornos aislados. Sin llamadas a API externas, sin medición por token, sin dependencia de proveedores. Tú controlas el tiempo de actividad, la latencia y las decisiones de escalado. Las organizaciones que han invertido en infraestructura GPU pueden ahora ejecutar un modelo de frontera genuino a coste marginal.
03
Ajuste Fino para Tu Dominio
El acceso completo al ajuste fino significa que puedes adaptar DeepSeek V4 Pro a tus datos, terminología y tareas específicas. Entrena con bases de código propietarias para mejorar la precisión técnica. Ajusta con documentos corporativos para que coincida con tu estilo de comunicación. Crea variantes específicas de dominio sin compartir tus datos de entrenamiento con terceros. El modelo ajustado resultante es tuyo — totalmente en propiedad y totalmente desplegable bajo la licencia MIT.
04
Soberanía de Datos — Tus Prompts Siempre en Tus Manos
Cuando te alojas en tu propia infraestructura, tus prompts, contexto y completados nunca salen de ella. Ningún proveedor de nube ve tus consultas. Ningún proveedor retiene el historial de conversaciones. No se aplican políticas de datos de entrenamiento. Para casos de uso en finanzas, sanidad, derecho y administración pública donde la residencia de datos y la confidencialidad son requisitos regulatorios, DeepSeek V4 Pro autoalojado es el primer modelo de clase frontera que hace que el cumplimiento normativo sea realmente alcanzable.

Qué Hace Diferente a DeepSeek V4 Pro

30× Más Barato que los Modelos Cerrados Comparables

A $0,435/M de tokens de entrada, DeepSeek V4 Pro cuesta 11× menos que GPT-5.5 ($5/M) y 34× menos que Claude Opus 4.8 ($15/M). Con el caché de prompts a $0,003625/M, las cargas de trabajo con contexto repetido se acercan a coste cero. Una pipeline de producción que procesa 10 millones de tokens de salida al día cuesta $261/mes con DeepSeek frente a $7.500/mes con Claude. El mismo presupuesto que cubría un caso de uso puede financiar ahora treinta.

Licencia MIT — El Único Modelo de Frontera Verdaderamente Libre

La IA de código abierto existe desde hace años, pero ningún modelo de pesos abiertos había igualado los benchmarks de frontera de los modelos cerrados hasta DeepSeek V4 Pro. La licencia MIT elimina toda restricción comercial: construye productos, despliégalos a cualquier escala, ajústalos libremente y conserva tus derivados. Es la licencia más permisiva asociada al modelo de pesos abiertos más capaz jamás publicado.

MoE de 1,6T — Profundo sin ser Costoso

1,6 billones de parámetros proporcionan un conocimiento enciclopédico en código, ciencia, matemáticas y lenguaje. Solo 49.000 millones se activan por inferencia — igualando la huella computacional de un modelo denso de tamaño medio. Las hiperconexiones con restricción de variedad y la arquitectura de caché KV híbrida garantizan que estos 49.000 millones de parámetros activos rinden muy por encima de su peso. Obtienes calidad de salida de frontera sin el coste de inferencia de frontera.

Entrenado en Huawei Ascend — Primera Frontera Sin Nvidia

DeepSeek V4 Pro fue entrenado exclusivamente en aceleradores Huawei Ascend 950 y Cambricon AI. Es el primer modelo de clase frontera verificado entrenado sin una sola GPU de Nvidia. Esto demuestra que la independencia de la cadena de suministro de IA ya no es teórica — un equipo que opera fuera del ecosistema Nvidia ha igualado o superado modelos entrenados en los clústeres de GPU más costosos del mundo.

Rendimiento en Benchmarks

DeepSeek V4 Pro en evaluaciones de programación, razonamiento, matemáticas y ciencias

SWE-bench Verified (Programación) 80.6%
Ties Claude Opus 4.8 for top open-weight score. Outperforms every prior open-source model on real-world software engineering tasks.
LiveCodeBench (Programación Competitiva) 93.5%
Beats all closed models including GPT-5.5 (~90%) and Claude Opus 4.8 (~88%). Best-in-class result on live coding challenges.
Codeforces Rating 3,206
Grandmaster-level competitive programming rating. No other open-weight model comes close on this rigorous algorithmic benchmark.
MMLU-Pro (Conocimiento Multidisciplinar) Top Tier
Frontier performance across STEM, humanities, and professional domains. Matches closed-model leaders on knowledge-intensive tasks.
GPQA Diamond (Ciencias a Nivel de Doctorado) Top 3
Expert-level performance on graduate science questions requiring deep reasoning across biology, chemistry, and physics.
Terminal-Bench 2.0 (Agéntico) 67.9%
Outperforms Claude Opus 4.8 (65.4%) on autonomous multi-step terminal tasks. Strong agentic intelligence score of 63.8.

Quién Usa DeepSeek V4 Pro — y Cómo

3 Modos de Razonamiento — Un Modelo

Ajusta el coste, la velocidad y la profundidad por solicitud sin cambiar de modelo

Non-Think
Respuestas directas e instantáneas para consultas sencillas. Sin procesamiento de cadena de pensamiento, latencia mínima, menor coste por token. Ideal para clasificación, resumen, traducción, preguntas y respuestas simples, y tareas de alto volumen donde la velocidad y la economía importan más que la profundidad.
Think High
Razonamiento estructurado paso a paso para problemas de múltiples partes. El modelo planifica explícitamente antes de responder — descomponiendo tareas complejas en subproblemas, verificando pasos intermedios y construyendo soluciones largas coherentes. Ideal para tareas de programación, escritura analítica, análisis de datos y explicaciones técnicas.
Think Max
Máxima profundidad de razonamiento para los problemas más difíciles. Cadenas multietapa extendidas, verificación recursiva, prueba exhaustiva de hipótesis. El rendimiento de Codeforces 3.206 y GPQA Diamond opera en este modo. Ideal para programación competitiva, preguntas de investigación a nivel de doctorado, matemáticas avanzadas y decisiones de diseño arquitectónico donde la precisión prima sobre la velocidad.

Preguntas Frecuentes

DeepSeek V4 Pro es un modelo de lenguaje grande de código abierto desarrollado por DeepSeek AI, publicado en 2026 bajo la licencia MIT. Utiliza una arquitectura Mixture of Experts con 1,6 billones de parámetros totales y 49.000 millones activos por token, alcanzando el 80,6% en SWE-bench Verified — igualando a los mejores modelos de código cerrado — a $0,435 por millón de tokens de entrada. Admite una ventana de contexto de 1 millón de tokens, tres modos de razonamiento y una API totalmente compatible con OpenAI.
DeepSeek V4 Pro cuesta $0,435/M de tokens de entrada y $0,87/M de tokens de salida mediante API. Los aciertos de caché de prompts cuestan $0,003625/M — prácticamente gratuitos para contextos repetidos. Esto lo hace aproximadamente 11× más barato que GPT-5.5 ($5/M de entrada) y 34× más barato que Claude Opus 4.8 ($15/M de entrada) para una calidad de salida equivalente. El autoalojamiento no tiene costes por token más allá de tu propia infraestructura.
Sí. DeepSeek V4 Pro se publica bajo la licencia MIT — la licencia de código abierto más permisiva. El uso comercial, el ajuste fino, el autoalojamiento y la creación de modelos derivados están todos permitidos sin restricciones, sin royalties y sin límites de usuarios. Los pesos del modelo están disponibles públicamente en HuggingFace. Esto supone un compromiso de código abierto más estricto que la licencia de Llama de Meta, que incluye excepciones de uso comercial.
Mixture of Experts (MoE) significa que el modelo tiene 1,6 billones de parámetros totales distribuidos en muchas subredes especializadas llamadas «expertos». Para cada token procesado, una capa de enrutamiento selecciona solo ~49.000 millones de parámetros para activar — los expertos más relevantes para esa entrada concreta. El resultado: la amplitud de conocimiento de un modelo de 1,6 billones de parámetros al coste de inferencia de un modelo de ~49.000 millones. Esta eficiencia arquitectónica es la razón por la que DeepSeek V4 Pro alcanza benchmarks de frontera con precios de modelo de tamaño medio.
Non-Think ofrece respuestas rápidas y directas sin procesamiento de cadena de pensamiento — ideal para consultas simples y cargas de trabajo de alto volumen. Think High habilita el razonamiento estructurado paso a paso para problemas de múltiples partes, depuración y análisis. Think Max aplica la máxima profundidad de razonamiento para los desafíos más difíciles — programación competitiva, investigación a nivel de doctorado, matemáticas complejas. Los tres modos están disponibles en el mismo endpoint del modelo; tú seleccionas el punto de operación por solicitud.
Sí. La licencia MIT otorga plenos derechos para desplegar DeepSeek V4 Pro en tu propio hardware — en la nube, en local o en entornos aislados. Los pesos del modelo están disponibles en HuggingFace. Necesitarás una capacidad GPU considerable dado el tamaño del modelo; sin embargo, la huella de 49.000 millones de parámetros activos de la arquitectura MoE significa que el coste de inferencia por token es menor que el de un modelo denso con un recuento de parámetros equivalente. El autoalojamiento es el camino recomendado para organizaciones con requisitos de soberanía de datos.
En SWE-bench Verified, ambos modelos obtienen aproximadamente el 80% — paridad estadística para tareas de programación del mundo real. DeepSeek V4 Pro lidera en LiveCodeBench (93,5% frente a ~90%) y en programación competitiva. GPT-5.5 lidera en algunos benchmarks agénticos como Terminal-Bench (82,7% frente a 67,9%). La diferencia crítica es el coste y la apertura: DeepSeek V4 Pro cuesta 11× menos por token, admite autoalojamiento y tiene licencia MIT completa — GPT-5.5 es de código cerrado sin opción de autoalojamiento.
DeepSeek V4 Pro admite una ventana de contexto de 1 millón de tokens — equivalente a unas 750.000 palabras o varias novelas completas. Su arquitectura híbrida Compressed Sparse Attention (CSA) más Hybrid Chunk Attention (HCA) procesa 1 millón de tokens de contexto con solo el 27% de los FLOPs requeridos por V3.2. Esto hace que el procesamiento de contexto largo sea económicamente viable a escala, a diferencia de los modelos densos donde el contexto de 1 millón de tokens multiplica el cómputo y el coste proporcionalmente.
Sí. DeepSeek V4 Pro utiliza un formato de API compatible con OpenAI. Migrar desde modelos GPT requiere cambiar un solo parámetro: la base_url. Sin instalación de nuevos SDK, sin reescritura de prompts, sin reestructuración del flujo de trabajo. Las solicitudes en formato Anthropic también son compatibles para equipos que migran desde Claude. Las integraciones existentes con LangChain, LlamaIndex y la API directa funcionan sin modificaciones.
DeepSeek V4 Pro fue entrenado exclusivamente en aceleradores Huawei Ascend 950 y Cambricon AI — convirtiéndolo en el primer modelo de lenguaje de clase frontera verificado entrenado sin GPUs de Nvidia. Esto tiene implicaciones significativas para la resiliencia de la cadena de suministro de IA. Demuestra que el entrenamiento de modelos de frontera ya no depende exclusivamente del ecosistema CUDA de Nvidia, y valida el hardware de IA de Huawei como una alternativa viable para el desarrollo de modelos a gran escala.

Privacy preferences

Choose which optional cookies you allow. Necessary cookies are always enabled.