Pide. Lo construye.
Lenguaje natural como entrada, ejecución autónoma como salida. GPT-5.5 Pro en Yesmind se encarga del resto.
¿Qué es GPT-5.5 Pro?
GPT-5.5 Pro es el modelo de lenguaje más capaz de OpenAI hasta la fecha — una <span class="hl-pill">reconstrucción desde cero</span> de la arquitectura GPT, no un parche incremental. Denominado internamente "Spud", representa el primer modelo base completamente reentrenado desde GPT-4.5. El resultado es un <span class="hl-pill">modelo de IA de frontera</span> que no se limita a responder instrucciones — planifica, razona y ejecuta tareas de múltiples pasos como lo haría un ingeniero experto ante un proyecto complejo.
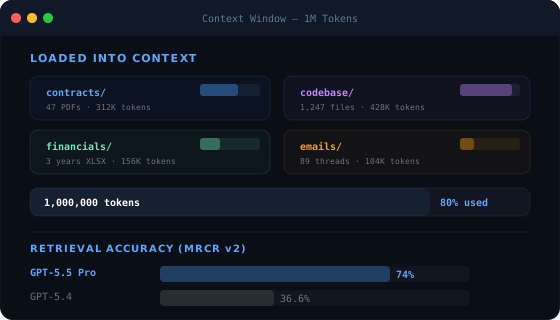
Mientras que los modelos anteriores requerían una ingeniería de prompts cuidadosa para mantenerse en el camino correcto, GPT-5.5 Pro introduce la <span class="hl-pill">resolución de problemas a largo plazo</span> como capacidad nativa. Su ventana de contexto de 1 millón de tokens no es solo una cifra llamativa — la recuperación MRCR v2 con 512K–1M tokens alcanza el 74 %, frente al 36,6 % de GPT-5.4. Bases de código completas, conjuntos de documentos legales y corpus de investigación caben en una sola conversación sin perder coherencia.
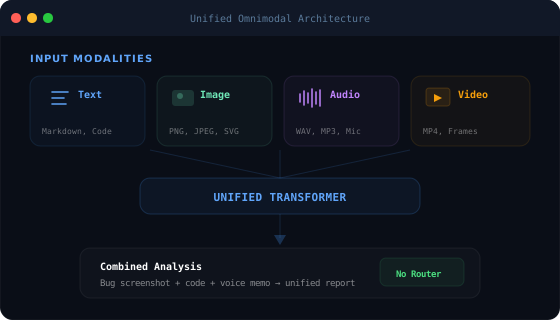
El modelo es también <span class="hl-pill">nativamente omnimodal</span>: texto, imágenes, audio y vídeo comparten una arquitectura unificada sin sobrecarga por cambio de modalidad. Combina eso con el 82,7 % en <span class="hl-pill">Terminal-Bench 2.0</span> — 13 puntos por delante de Claude Opus 4.7 — y tienes el primer modelo que merece realmente la etiqueta de agente de IA autónomo para cargas de trabajo de producción reales.
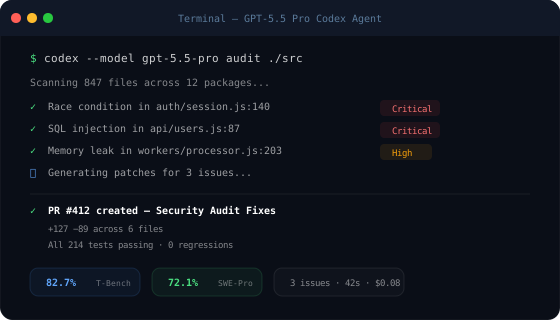
Programación agéntica
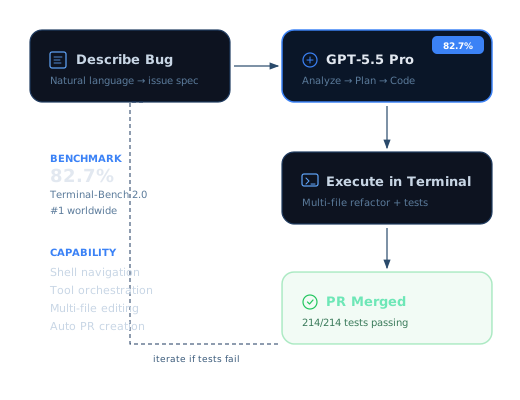
82,7 % en Terminal-Bench 2.0 — 13 puntos por delante de Claude Opus 4.7. Navegación autónoma por el shell, orquestación de herramientas y manipulación de bases de código con múltiples archivos. No es un asistente — es un ingeniero autónomo.
Contexto de 1 M de tokens
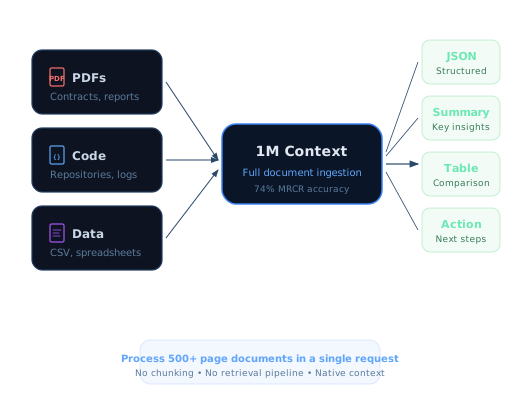
1 M de tokens con un 74 % de precisión de recuperación en MRCR v2 — 2× GPT-5.4, 2,3× Claude Opus 4.7. Aliméntalo con un repositorio entero, un año de documentos o un expediente completo. Lee, retiene y razona sobre todo ello.
Nativamente omnimodal
Texto, imágenes, audio, vídeo — una arquitectura unificada. Sin enrutador de modalidades, sin pérdida de conversión. Captura de pantalla + código, vídeo + transcripción, PDF + gráfico + nota de voz en una sola solicitud.
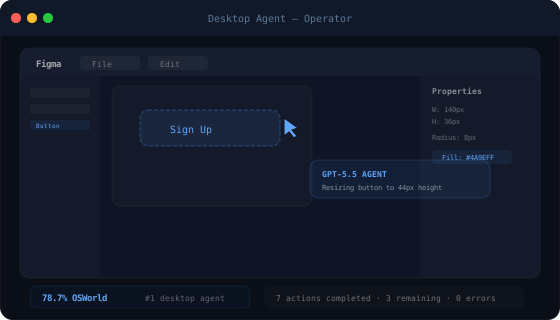
Uso del ordenador
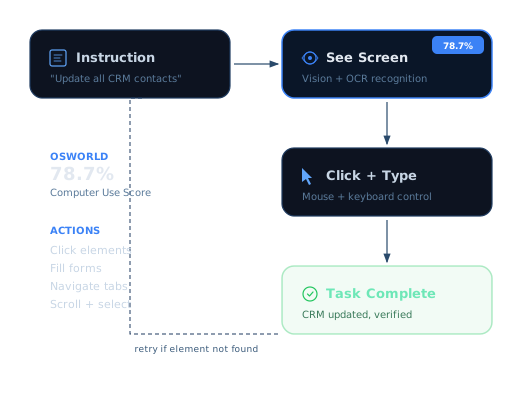
78,7 % en OSWorld — automatización de escritorio real. Navega por interfaces gráficas, rellena formularios, opera aplicaciones y ejecuta flujos de trabajo de varios pasos. El uso del ordenador pasa de la demo al despliegue.
Investigación web
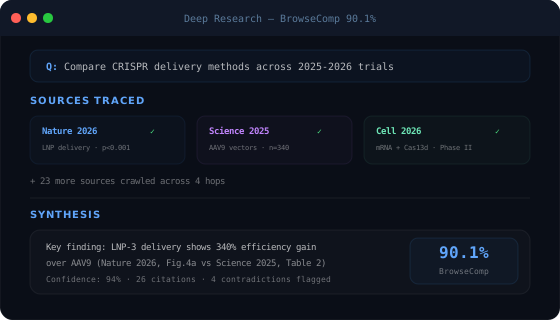
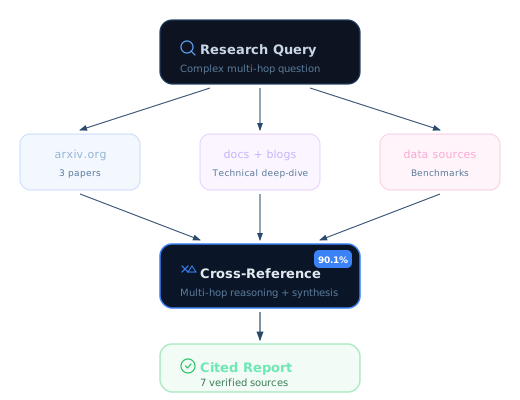
90,1 % en BrowseComp — consultas de múltiples saltos a través de decenas de fuentes. Supera a Gemini 3.1 Pro (85,9 %) y a Claude Opus 4.7 (79,3 %). Cadenas de evidencia autónomas con conclusiones citadas.
Qué hace diferente a GPT-5.5 Pro
Reconstrucción desde cero
GPT-5.5 Pro no es GPT-5.4 con capas adicionales. Es el primer modelo base completamente reentrenado desde GPT-4.5 — una revisión arquitectónica completa con el nombre en clave "Spud". Cada mejora de capacidad se construye sobre una base más sólida, no sobre parches a limitaciones existentes. Por eso los saltos en los benchmarks son discontinuos: no estás comparando versiones, estás comparando generaciones.
Paridad de velocidad por token
Más capaz no tiene por qué significar más lento. GPT-5.5 Pro fue codiseñado con hardware NVIDIA GB200 y GB300 para lograr una velocidad de generación de tokens superior en más de un 20 % respecto a GPT-5.4, ofreciendo al mismo tiempo mayor capacidad. Los pipelines de producción obtienen un modelo más rápido y más inteligente simultáneamente — una combinación que hasta ahora no había existido en el desarrollo de modelos de frontera.
72 % menos de tokens de salida
A pesar de un precio de lista por token más alto ($30/M de salida), GPT-5.5 Pro genera aproximadamente un 72 % menos de tokens de salida que Claude Opus 4.8 para completar tareas de codificación equivalentes. El modelo se comunica con precisión y actúa con eficiencia, lo que significa que el coste real para los pipelines de codificación agéntica es aproximadamente la mitad del equivalente con Claude. Mejores benchmarks con un gasto real menor.
Codiseño con hardware NVIDIA
GPT-5.5 Pro no fue entrenado de forma aislada y desplegado en hardware estándar. OpenAI y NVIDIA codiseñaron la arquitectura del modelo junto con el rack GB200/GB300 NVL72, lo que permite optimizaciones a nivel de kernel que son invisibles para los modelos entrenados por separado. El resultado es una eficiencia de inferencia que multiplica la ventaja de coste de las secuencias de salida más cortas.
GPT-5.5 Pro vs la competencia
Resultados de benchmarks independientes — todos los modelos disponibles en Yesmind.
| Features |  GPT-5.5 Pro OpenAI |  Claude Opus 4.8 Anthropic |  Gemini 3.5 Flash Google |  DeepSeek V4 Pro DeepSeek |
|---|---|---|---|---|
| Terminal-Bench 2.0 | 82.7% | ~70% | 68.5% | TBD |
| ARC-AGI-2 | 85.0% | 75.8% | 77.1% | TBD |
| FrontierMath T1–3 | 51.7% | 43.8% | 36.9% | TBD |
| BrowseComp | 90.1% | 79.3% | 85.9% | TBD |
| OSWorld (Uso del ordenador) | 78.7% | 78.0% | TBD | TBD |
| Ventana de contexto | 1M tokens | 200K+ tokens | 1M+ tokens | 1M tokens |
| MRCR v2 (512K–1M) | 74% | 32.2% | TBD | TBD |
| Precio de salida | $30/M tokens | $25/M tokens | $3.50/M tokens | $0.44/M tokens |
| Programación agéntica | ||||
| Uso del ordenador | ||||
| Nativamente omnimodal |
Rendimiento en benchmarks
GPT-5.5 Pro en las evaluaciones clave que importan para cargas de trabajo reales
Qué construye la gente con GPT-5.5 Pro
Coding Agents
Ingeniería de software autónoma a escala. GPT-5.5 Pro navega por bases de código, escribe y prueba código, resuelve problemas en múltiples archivos y envía pull requests funcionales sin necesidad de supervisión. La puntuación del 82,7 % en Terminal-Bench refleja cómo funciona esto en producción.
Research Workflows
Investigación profunda de múltiples fuentes que antes requería un equipo de analistas. La puntuación del 90,1 % en BrowseComp de GPT-5.5 Pro significa que puede rastrear datos poco conocidos, sintetizar fuentes contradictorias y devolver un resumen citado — el tipo de resultado de investigación que antes requería horas.
Document Processing
Proporciona a GPT-5.5 Pro un conjunto completo de contratos legales, un paquete de auditoría financiera o una biblioteca de especificaciones técnicas. Con 1 M de tokens de contexto y un 74 % de precisión de recuperación en MRCR v2, nada se escapa. Extrae, compara, resume y señala — en documentos que antes requerían equipos especializados.
Desktop Automation
La puntuación del 78,7 % en OSWorld de GPT-5.5 Pro se traduce en la ejecución real de tareas de escritorio: navegar por interfaces de usuario complejas, rellenar formularios en distintas aplicaciones, coordinar flujos de trabajo entre múltiples aplicaciones y completar tareas que antes requerían una persona delante del teclado. Uso del ordenador que realmente funciona en producción.
Cómo funciona GPT-5.5 Pro
De un solo prompt a la ejecución autónoma de múltiples pasos
Tú defines el objetivo
Describe lo que quieres conseguir — no cómo hacerlo. GPT-5.5 Pro acepta lenguaje natural, código, imágenes, documentos y audio como entrada. Tú defines el objetivo; el modelo determina el enfoque. Cuanto más contexto proporciones, con más precisión podrá planificar.
El modelo planifica y razona
GPT-5.5 Pro descompone el objetivo en una secuencia de pasos, identifica qué herramientas e información se necesitan y elabora un plan de ejecución antes de actuar. Este paso de razonamiento interno — escalado drásticamente en la variante Thinking — es lo que separa la ejecución autónoma de la generación de respuestas reactivas.
Ejecución autónoma
El modelo ejecuta el plan: llama a herramientas, navega por la web, escribe y ejecuta código, opera aplicaciones o coordina flujos de trabajo de varios pasos. Cada resultado intermedio se evalúa antes de continuar con el siguiente paso. Recibes un resultado completo y verificado — no un borrador a medias.
Lo que dicen los creadores sobre GPT-5.5 Pro
A Top-End Senior Engineer
GPT-5.5 scored 62.5 on Every's Senior Engineer Benchmark — nearly double Opus 4.7's 33.5. It rewrites messy production codebases the way a senior engineer would, with cleaner structure and smoother logical progression.
It’s rare for a model to feel easier and stronger at the same time. GPT-5.5 is fast enough to use constantly, personable enough to collaborate with, and assertive enough to carry a plan through serious engineering work.
Code Review That Catches What Humans Miss
Ramp's AI DevEx team integrated Codex with GPT-5.5 into their code review flow. Engineers now request it by name for its thoroughness and ability to reason deeply against the codebase.
Codex code review catches things that I miss and that other engineers miss and that other AI code reviewers definitely miss.
Smarter and More Efficient Than Opus
Developers on r/ClaudeCode compared GPT-5.5 directly against Opus 4.7 for software design. The consensus: GPT-5.5 produces higher quality code with fewer tokens and offers substantially higher usage limits.
It is smarter than Opus and more efficient. GPT reviewed my codebase which was done by Opus 4.6 and 4.7 and it found so many bugs. The code quality is great and the speed is so much faster.
Eficiencia de tokens: la ventaja de coste oculta
Con $30 por millón de tokens de salida, el precio de lista de GPT-5.5 Pro es superior al de Claude Opus 4.8, que se sitúa en $25/M. Sobre el papel, eso supone un 20 % más caro. En la práctica, ocurre lo contrario para las cargas de trabajo que más importan.
<strong>GPT-5.5 Pro genera aproximadamente un 72 % menos de tokens de salida que Claude Opus 4.8</strong> para completar las mismas tareas de codificación. Escribe código más conciso, elimina comentarios verbosos y llega a conclusiones sin preámbulos. Esa ventaja de eficiencia invierte la comparación de precios por token: el coste efectivo por tarea completada es aproximadamente la mitad del equivalente con Claude en pipelines de ingeniería.
La ganancia de eficiencia se amplifica con la mejora de más del 20 % en la velocidad de generación de tokens respecto a GPT-5.4. Una inferencia más rápida se traduce en menor tiempo de reloj por solicitud, lo que reduce directamente el coste de los flujos de trabajo agénticos sensibles al tiempo donde la latencia afecta al rendimiento. Los equipos que realizan miles de llamadas a la API diariamente comprueban que la factura real no tiene nada que ver con los cálculos teóricos.
<strong>La implicación práctica:</strong> dirige tu trabajo de codificación agéntica de mayor volumen a través de GPT-5.5 Pro. La ventaja en benchmarks se paga sola antes de la primera factura.