4× más rápido. Misma inteligencia.
Gemini 3.5 Flash — el modelo frontera más rápido. $0,15/M entrada, $0,60/M salida. Razonamiento bajo demanda. En Yesmind.
¿Qué es Gemini 3.5 Flash?
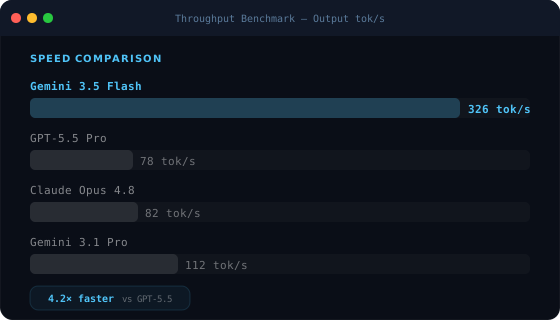
Gemini 3.5 Flash es el <span class="hl-pill">modelo de IA de vanguardia más rápido</span> de Google, lanzado el 19 de mayo de 2026 en Google I/O. A unos <span class="hl-pill">280 tokens de salida por segundo</span>, se ejecuta aproximadamente 4× más rápido que GPT-5.5 y Claude Opus 4.8 — igualando o superándolos en programación agéntica, recuperación de contexto largo y benchmarks multimodales. Está disponible de forma general hoy como <code>gemini-3.5-flash</code> sin sufijo de vista previa ni lista de espera.
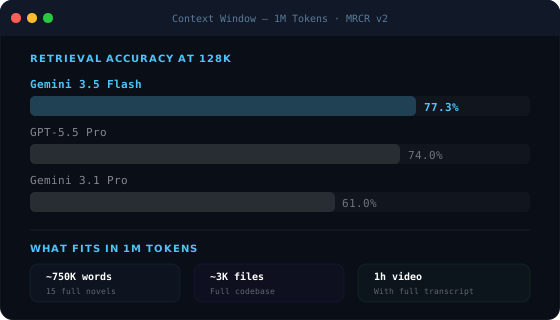
La tesis central del modelo es que la velocidad y la inteligencia ya no son un compromiso. <span class="hl-pill">SWE-Bench 81.0%</span> y <span class="hl-pill">Terminal-Bench 76.2%</span> superan ambos al modelo Pro de nivel anterior del propio Google. En el benchmark de recuperación de contexto largo MRCR v2, Gemini 3.5 Flash obtiene un 77.3% con 128k tokens — frente al 46.9% de Claude Opus 4.8 y el 41.4% de GPT-5.5. Este no es un modelo recortado para tareas de bajo coste; es un motor de <span class="hl-pill">inteligencia de clase vanguardia</span> completo construido para cargas de trabajo agénticas de nivel producción.
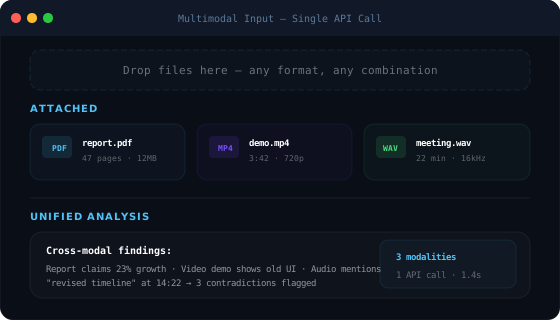
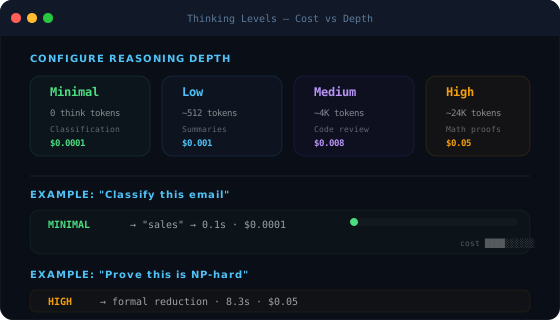
<span class="hl-pill">La verdadera multimodalidad nativa</span> diferencia a Gemini 3.5 Flash de todos sus competidores: texto, imagen, audio, vídeo y PDF se procesan en una sola llamada API, sin enrutamiento de modelos separado ni pipeline de preprocesamiento. Combinado con los <span class="hl-pill">Thinking Levels</span> (de Minimal a High) para un control granular de coste-calidad, y una integración profunda en la infraestructura agéntica Antigravity 2.0 de Google, Gemini 3.5 Flash es el modelo al que recurrir cuando necesitas resultados de vanguardia con un presupuesto de producción.
Ventaja de velocidad 4×
~326 tok/s de salida — 4× más rápido que GPT-5.5 Pro (78 tok/s) y Claude Opus 4.8 (82 tok/s). Para pipelines agénticos que procesan millones de tokens al día, esta diferencia se traduce directamente en ahorro de costes y latencia.
Multimodalidad Verdaderamente Nativa
Texto, imágenes, audio, vídeo, PDFs — una llamada al modelo, sin enrutamiento, sin preprocesamiento. 84% MMMU-Pro — la puntuación multimodal más alta registrada. Cinco modalidades de forma nativa, no como complementos.
Contexto de 1M de Tokens con la Mejor Recuperación
1M de tokens con un 77.3% de recuperación MRCR v2 a 128K — frente al 46.9% de Claude Opus y el 41.4% de GPT-5.5. No solo acepta contextos largos — los recupera con precisión.
Niveles de Pensamiento
Cuatro modos — Minimal, Low, Medium, High — ajustan el coste y la profundidad por solicitud. Minimal: $0.0001 para clasificación. High: razonamiento completo para demostraciones matemáticas. Un endpoint, cuatro perfiles, cero complejidad de infraestructura.
Integración con el Ecosistema de Google
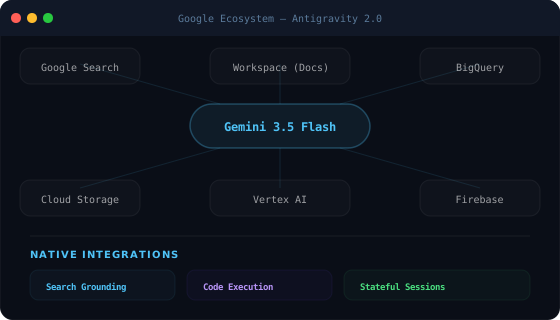
Antigravity 2.0: sandboxes con estado, paralelismo multiagente, herramientas MCP — integradas. La búsqueda nativa con grounding reemplaza al RAG. Integración directa con Workspace, BigQuery, Vertex AI, Firebase.
Gemini 3.5 Flash frente a los principales competidores
Datos de benchmarks independientes — descubre dónde gana cada modelo y dónde hace concesiones.
| Features |  Gemini 3.5 Flash Google |  GPT-5.5 OpenAI |  Claude Opus 4.8 Anthropic |  DeepSeek V4 Pro DeepSeek |
|---|---|---|---|---|
| Velocidad de salida (tok/s) | ~280 | ~70 | ~60 | ~80 |
| SWE-Bench | 81.0% | ~80% | 80.6% | 80.6% |
| Terminal-Bench 2.1 | 76.2% | 82.7% | 69.4% | 67.9% |
| MRCR v2 128k | 77.3% | 41.4% | 46.9% | TBD |
| MMMU-Pro (Multimodal) | 84% | TBD | TBD | TBD |
| Ventana de contexto | 1M tokens | 1M tokens | 200K+ | 1M tokens |
| Precio de entrada por 1M | $1.50 | $5.00 | $15.00 | $0.435 |
| Precio de salida por 1M | $9.00 | $30.00 | $25.00 | $0.87 |
| Modalidades nativas | Text+Image+Audio+Video+PDF | Text+Image+Audio+Video | Text+Image | Text only |
| Modos de Pensamiento / Razonamiento | 4 levels (Minimal–High) | |||
| Infraestructura Agéntica | Antigravity 2.0 (native) | OpenAI Responses API | Claude Code | Limited |
| Descuento por caché de contexto | 90% ($0.15/M) | 50% | 90% | 75% |
Rendimiento en benchmarks
Gemini 3.5 Flash en evaluaciones independientes de terceros — agéntica, programación, multimodal y recuperación
Quién usa Gemini 3.5 Flash — y cómo
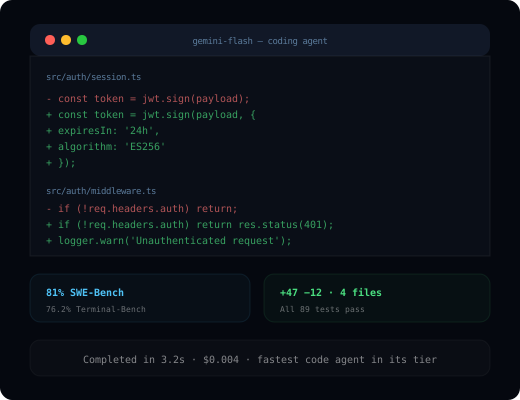
Agentic Coding
81% SWE-Bench, 76.2% Terminal-Bench. Sandboxes con estado de Antigravity 2.0 + paralelismo multiagente para flujos de trabajo con múltiples repositorios. Protocolos de herramientas MCP para pruebas, confirmaciones e implementaciones — de forma autónoma.
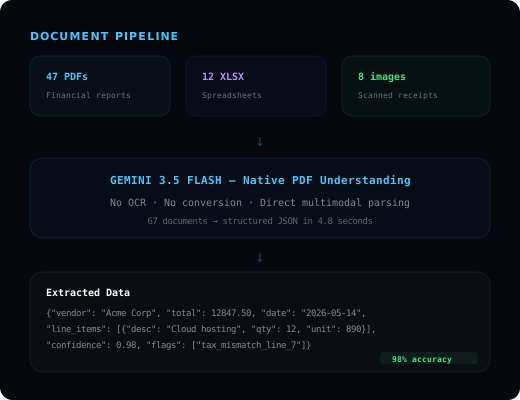
Document Processing
Comprensión nativa de PDF — sin OCR, sin conversión. Sube estados financieros, contratos o artículos de investigación y obtén JSON estructurado en una sola llamada. Contexto de 1M + 77.3% de precisión de recuperación.
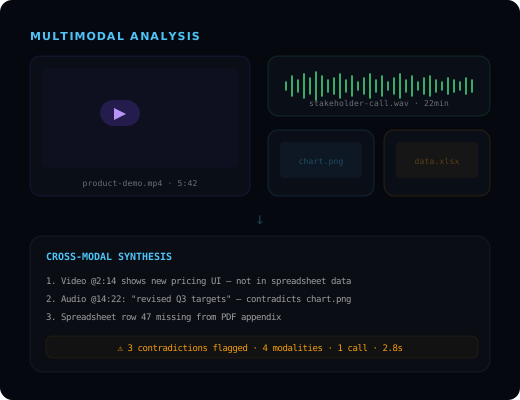
Multimodal Analysis
Vídeo + audio + imágenes + texto en una sola llamada API. Analiza demostraciones de productos, transcribe reuniones, cruza gráficos con hojas de cálculo. 84% MMMU-Pro — la puntuación multimodal más alta registrada.
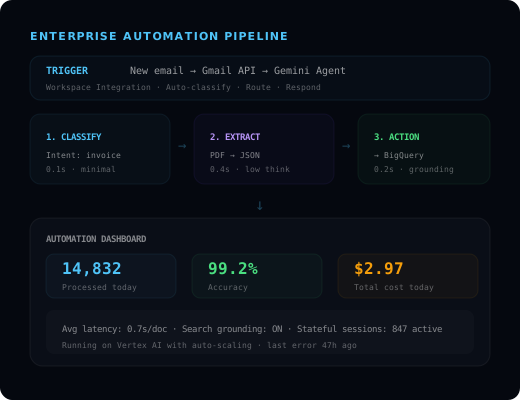
Enterprise Automation
Google Workspace, Search grounding, BigQuery, Vertex AI — todo nativo. 90% de descuento por caché de contexto. Los Thinking Levels ajustan el coste de cómputo a la complejidad de la tarea. Impulsa el Modo IA para más de 1.000 millones de usuarios.
Cómo Funciona
Cualquier modalidad de entrada, resultados instantáneos, infraestructura a escala de Google
Envía Cualquier Modalidad
Pasa texto, imágenes, audio, vídeo o documentos PDF — de forma individual o combinada — en una sola solicitud API. Sin preprocesamiento, sin enrutamiento separado de modelos, sin pipeline de conversión. El modelo acepta archivos en bruto junto con tu prompt y procesa todo de forma nativa.
Procesamiento Flash
Gemini 3.5 Flash se ejecuta a ~280 tokens de salida por segundo a través de la infraestructura TPU de producción de Google. Selecciona tu Thinking Level (de Minimal a High) para ajustar el presupuesto de razonamiento de tu tarea. El caché de contexto reduce el coste en un 90% para segmentos de documentos o prompts de sistema repetidos.
Respuesta Estructurada Instantánea
Recibe texto, JSON estructurado, código o salidas de llamadas a funciones en tiempo real mediante streaming. Para pipelines agénticos en Antigravity 2.0, el modelo puede invocar herramientas, lanzar subagentes y persistir el estado a través de tareas de varios pasos — todo dentro de la misma sesión.
Qué Hace Diferente a Gemini 3.5 Flash
4× Más Rápido que sus Rivales de Vanguardia
~280 tokens de salida por segundo sitúan a Gemini 3.5 Flash en una categoría propia en el nivel de inteligencia de vanguardia. GPT-5.5 ofrece ~70 tok/s; Claude Opus 4.8 ~60 tok/s. Para sistemas agénticos que procesan millones de tokens al día, la diferencia de rendimiento es lo que marca la línea entre ser económicamente viable o no. Este es el modelo que hace posible la IA en tiempo real con calidad de vanguardia.
Entrada Nativa de Cinco Modalidades
Texto, imagen, audio, vídeo y PDF — todo procesado de forma nativa en una sola llamada al modelo. Sin pipeline de OCR externo para PDFs. Sin paso separado de transcripción de audio. Sin preprocesamiento de imagen a texto. Los competidores gestionan una o dos modalidades de forma nativa; Gemini 3.5 Flash gestiona las cinco. MMMU-Pro 84% es la puntuación de benchmark multimodal más alta registrada.
77.3% de recuperación MRCR de contexto largo
Tener una ventana de contexto de 1M de tokens es una cosa. Recuperar realmente la información correcta de ella es otra. MRCR v2 a 128k: Gemini 3.5 Flash 77.3% frente a Claude Opus 4.8 46.9% frente a GPT-5.5 41.4%. Una ventaja de precisión de 30 puntos que importa en flujos de trabajo de documentos legales, financieros y de investigación, donde omitir una sola cláusula tiene consecuencias reales.
90% de Descuento en Caché de Contexto
El contexto repetido — prompts de sistema, documentos de referencia, historial de conversación — cuesta $0.15/M de tokens en caché en lugar de los $1.50/M estándar. Para flujos de trabajo agénticos que referencian la misma base de código, documento de políticas o base de conocimiento en miles de solicitudes, el caché por sí solo reduce el coste total de inferencia en un 30–50%. La economía de la IA de contexto largo cambia fundamentalmente a esta tasa de descuento.